TokenGate promete acelerar hasta 11,3 veces el prefill de modelos de IA
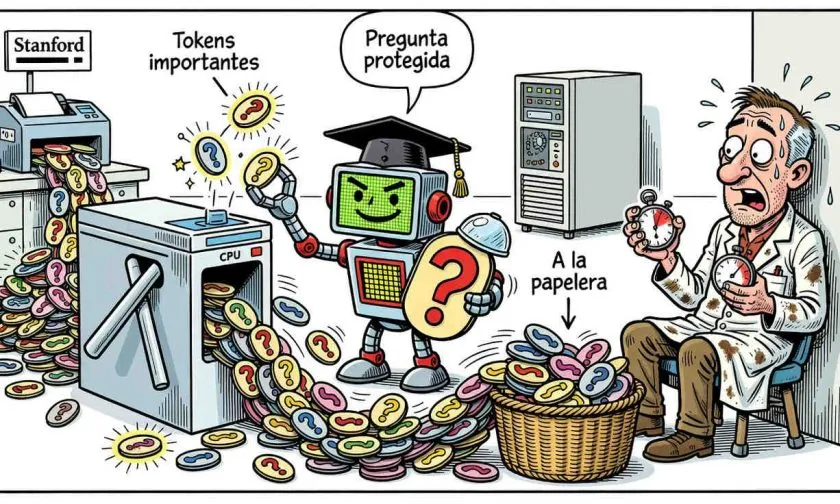
Un equipo de investigadores de las universidades de Stanford y UC Berkeley ha presentado una nueva técnica denominada TokenGate, diseñada para optimizar el rendimiento de los modelos de inteligencia artificial cuando manejan contextos extensos. El método consiste en un sistema inteligente que selecciona de forma selectiva qué fragmentos de información previa requieren un procesamiento completo y cuáles pueden simplificarse, reduciendo de manera drástica el esfuerzo computacional necesario antes de generar la primera respuesta.
Durante las pruebas experimentales realizadas con modelos del ecosistema Qwen, el enfoque demostró una capacidad notable para disminuir los tiempos de espera. Específicamente, el sistema logró acelerar el indicador de tiempo hasta el primer token hasta 11,3 veces en comparación con los métodos tradicionales de prefill completo, aunque los creadores señalaron que la magnitud de la mejora varía según la tarea específica y la configuración técnica empleada.
Para el sector tecnológico y las plataformas que integran infraestructura descentralizada, este avance tiene implicaciones directas en la eficiencia operativa. La gestión de contextos largos representa actualmente uno de los mayores cuellos de botella en términos de costes de servidor y consumo energético, por lo que cualquier innovación capaz de aligerar la carga computacional resulta clave para la escalabilidad de los servicios basados en modelos avanzados.
Distintos actores de la industria han recibido la propuesta con optimismo moderado, destacando que el filtrado inteligente de datos podría democratizar el acceso a capacidades avanzadas de procesamiento. Sin embargo, expertos en la materia coinciden en que todavía es necesario evaluar el comportamiento de TokenGate en entornos de producción a gran escala para confirmar si el ahorro de tiempo se traduce en una pérdida perceptible de precisión.
A corto plazo, el siguiente paso para los desarrolladores consistirá en refinar los algoritmos de selección y ampliar las pruebas a otros arquitecturas de código abierto. La comunidad sigue de cerca estos avances académicos, conscientes de que optimizar la fase inicial de lectura de datos es un paso fundamental para hacer que las aplicaciones de inteligencia artificial sean más rápidas y viables económicamente.

Equipo CoinMagnetic
Inversores en cripto desde 2017. Operamos con nuestro propio dinero y probamos cada exchange personalmente.
Actualizado: octubre de 2026
En nuestro analisis:
¿Quieres enterarte de las noticias primero?
Síguenos en nuestro canal de Telegram – publicamos noticias importantes y análisis.
Seguir el canalNoticias relacionadas
Estafa en un cajero de bitcoin: una nueva ley de Carolina del Norte prevé reembolsos desde 2027
Robinhood Chain alcanza USD 3.680 millones en tokens de acciones
Guía de la FCA para criptobusca blindar transferencias en Reino Unido
Las próximas criptomonedas ganadoras podrían ser diferentes a las actuales
Sobreseimiento judicial aparta a Javier Milei de la causa penal por la memecoin $LIBRA